Эмбеддинги от 21,6 ₽ за млн токенов · оплата в рублях · без VPN
RAG-система
поиск ИИ по вашим документам
RAG-система — это связка поиска и языковой модели: по вопросу человека сначала находятся нужные куски ваших документов, а потом модель пишет ответ, опираясь только на них. Модель не выдумывает — она пересказывает найденное, и на каждый ответ можно показать источник.
Мы даём для этого две вещи: модель эмбеддингов, которая превращает текст в векторы, и текстовые модели, которые пишут ответ по найденному. Один ключ, OpenAI-совместимый API, оплата в рублях по договору. Векторная база и сами документы остаются у вас.
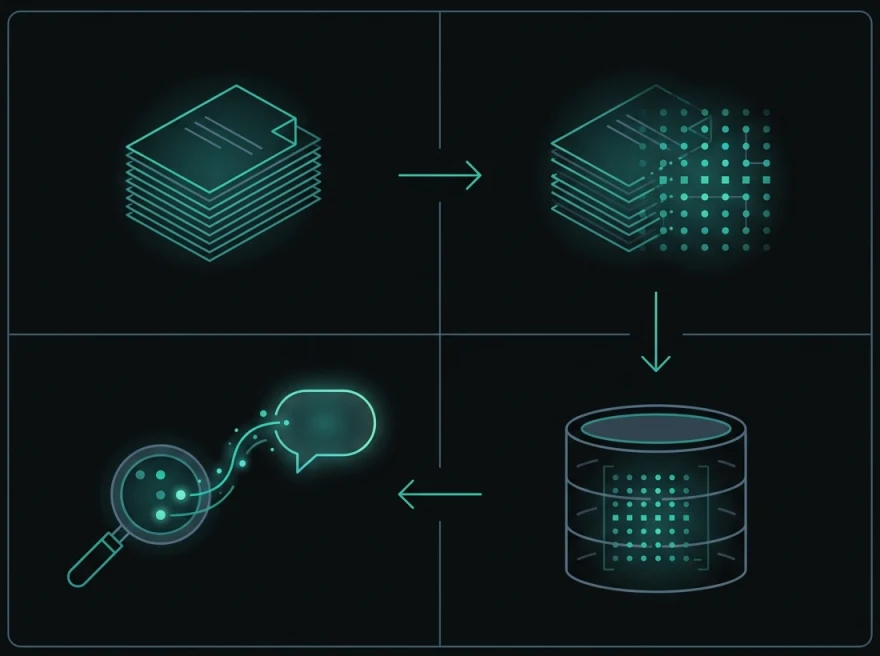
- 1 Документы режем на фрагменты по 200–500 слов
- 2 Каждый фрагмент становится вектором из 3072 чисел
- 3 Векторы ложатся в базу на вашем сервере
- 4 По вопросу достаются нужные, и модель пишет ответ
Первые три шага делаются один раз при загрузке базы. Четвёртый повторяется на каждый вопрос — он и определяет месячный счёт.
Зачем нужна RAG-система
Языковая модель знает то, на чём её обучали, и ничего не знает про вашу компанию: ни регламентов, ни договоров, ни истории обращений. Спросите её о внутреннем процессе — она сочинит правдоподобный ответ, и отличить его от правды будет нечем.
RAG решает это в лоб. Перед тем как отвечать, система ищет в ваших документах куски, относящиеся к вопросу, и подкладывает их модели вместе с запросом. Модель работает не по памяти, а по тексту, который ей дали — как человек, отвечающий с открытой папкой на столе.
Ключевая деталь — поиск идёт по смыслу, а не по словам. Вопрос «сколько дней даётся на возврат» найдёт пункт договора, где написано «срок рекламации — 14 календарных дней», хотя ни одно слово не совпало. Это и делают эмбеддинги.
Где это работает лучше всего
- →Поддержка. Оператор задаёт вопрос словами клиента и получает ответ со ссылкой на регламент, а не ищет его руками по вики.
- →Договоры и юридический архив. «Где у нас про неустойку за просрочку поставки» — по всем 400 договорам сразу.
- →Онбординг. Новый сотрудник спрашивает своими словами вместо того, чтобы дёргать коллег.
- →Каталог и техдокументация. Подбор товара или детали по описанию задачи, а не по артикулу.
- →Разбор обращений. Дедупликация заявок и раскладка по темам без ручных правил.
Из чего состоит RAG-система
Четыре части. Две из них — модели, и это то, что берём на себя мы. Две другие — обычный код и открытая база, они остаются на вашей стороне.
| Часть | Что делает | Чьё |
|---|---|---|
| Нарезка документов | Режет файлы на фрагменты по 200–500 слов и хранит рядом ссылку на источник | ваш код |
| Модель эмбеддингов | Превращает каждый фрагмент в вектор — набор чисел, который кодирует смысл | наша, 21,6 ₽ за 1 млн токенов |
| Векторная база | Хранит векторы и за миллисекунды находит ближайшие к вопросу. Qdrant, Chroma, pgvector | ваша, бесплатно |
| Модель для ответа | Читает найденные фрагменты и пишет по ним связный ответ на языке вопроса | наша, любая из каталога |
Важное ограничение. Векторы разных моделей между собой несовместимы. Если однажды сменить модель эмбеддингов, базу придётся переиндексировать целиком — иначе поиск начнёт выдавать мусор, причём молча. Поэтому на маршруте эмбеддингов у нас намеренно нет автоматического фолбэка на другого поставщика: лучше честная ошибка, чем испорченная база.
Сколько стоит RAG-система в рублях
Расходов два: разовая индексация базы и оплата за каждый заданный вопрос. Посчитаем на компании, у которой внутренняя вики примерно на 10 миллионов токенов — это около 7 500 страниц текста.
Разово — индексация
216 ₽
10 млн токенов × 21,6 ₽ за миллион. Платится один раз при первой загрузке базы. Дальше — только за новые и изменённые документы: обновить сотню страниц стоит меньше трёх рублей.
Ежемесячно — 1000 вопросов
40–450 ₽
Зависит от того, какая модель пишет ответ. На каждый вопрос уходит около 4 000 входных токенов (пять найденных фрагментов плюс сам вопрос) и 300 выходных.
| Модель для ответа | Ввод / вывод, ₽ за 1 млн | 1000 вопросов в месяц |
|---|---|---|
| GLM-5.3 Flash | 8,1 / 27 | ≈ 41 ₽ |
| Gemini 3.8 Flash | 81 / 405 | ≈ 446 ₽ |
| Claude Sonnet 5 | 216 / 1 080 | ≈ 1 188 ₽ |
На этой задаче модель не рассуждает, а пересказывает готовое — поэтому флагман здесь почти никогда не нужен. Разумный порядок действий: собрать на дешёвой модели, посмотреть на реальных вопросах, и поднимать класс только если ответы действительно не устраивают. Смена модели — это одна строка в коде, а не новая интеграция.
Когда RAG не нужен
Современные модели держат в контексте до миллиона токенов — это примерно 2 500 страниц. Если весь ваш корпус документов меньше сотни страниц, никакой RAG не нужен: складывайте документы прямо в запрос и не стройте инфраструктуру.
Ломается этот подход не на размере базы, а на числе вопросов. Сотня страниц — это около 70 000 токенов, и вы платите за них при каждом запросе: на Gemini 3.8 Flash это 5,7 ₽ за вопрос. Пятьдесят вопросов в месяц — 285 ₽, и городить RAG незачем. Тысяча вопросов — уже 5 700 ₽ против 450 ₽ у RAG.
Так что считайте по частоте обращений, а не по объёму архива. И проверьте вторую вещь: если вопросы к базе задаются раз в неделю двумя людьми, выигрыш будет не в деньгах и не во времени, а его не будет вовсе.
Чего RAG не делает
- ✕Не считает. Вопросы вида «какая выручка за квартал» — это запрос к базе данных, а не поиск по смыслу.
- ✕Не наводит порядок. Если регламенты противоречат друг другу, система найдёт оба и ответит уверенно по случайному.
- ✕Не убирает проверку. Ответ надо показывать со ссылкой на источник — чтобы человек мог открыть и убедиться.
- ✕Не заменяет права доступа. Разграничение «кому какие документы видно» делается до поиска, на вашей стороне.
Как собрать RAG-систему на нашем ключе
Адрес API один на весь каталог — https://api.kosareva.cloud/v1, схема совпадает с OpenAI. Если у вас уже есть код на LangChain или LlamaIndex, менять нужно ровно две строки: базовый адрес и ключ.
Посчитать векторы для фрагментов
Список строк за один запрос — так индексация идёт пачками, а не по одной. Полученные векторы кладутся в векторную базу вместе с текстом фрагмента.
from openai import OpenAI

client = OpenAI(
    api_key="ВАШ_КЛЮЧ_KOSAREVA",
    base_url="https://api.kosareva.cloud/v1",
)

fragments = [
    "Срок рекламации — 14 календарных дней с момента получения товара.",
    "Возврат оформляется через личный кабинет, раздел «Заказы».",
]

response = client.embeddings.create(model="gemini-embedding-2", input=fragments)
vectors = [row.embedding for row in response.data]
print(len(vectors), len(vectors[0]))  # 2 3072
Найти нужные фрагменты по вопросу
Вопрос превращается в вектор той же моделью, а векторная база возвращает ближайшие к нему фрагменты. Пяти обычно достаточно.
question = "сколько дней даётся на возврат"

qvec = client.embeddings.create(
    model="gemini-embedding-2", input=question
).data[0].embedding

# поиск в вашей векторной базе — Qdrant, Chroma, pgvector
found = store.search(qvec, limit=5)  # список текстов фрагментов
Получить ответ по найденному
Найденные куски отдаются модели вместе с вопросом. Инструкция «отвечай только по тексту» — не формальность: без неё модель дополнит ответ своими знаниями, и отличить одно от другого будет нельзя.
answer = client.chat.completions.create(
    model="gemini-3-8-flash",
    messages=[
        {"role": "system", "content":
            "Отвечай только по приведённым фрагментам. "
            "Если ответа в них нет — так и скажи."},
        {"role": "user", "content":
            "Фрагменты:\n" + "\n\n".join(found) + f"\n\nВопрос: {question}"},
    ],
)
print(answer.choices[0].message.content)
Тот же ключ работает с LangChain, LlamaIndex, n8n и любым клиентом, который умеет OpenAI-совместимый эндпоинт. Отдельного ключа под каждую модель заводить не нужно — один ключ открывает весь каталог, включая эмбеддинги.
Собрать под ключ или получить ключ
Если в компании есть разработчик — заводите ключ в кабинете и собирайте сами, это работа на несколько дней. Если разработчика нет, соберём мы: внедрение ИИ — фиксированные пакеты, база знаний внутри.
-
Документы остаются у вас
Векторная база разворачивается в вашем контуре. Наружу уходит только текст фрагмента в момент расчёта вектора.
-
Обезличивание, если нужно
Шлюз API Guard заменяет почты, телефоны, ИНН и паспорта на заглушки, а в ответе возвращает настоящие значения.
-
Договор с юрлицом и закрывающие документы
ООО «Kosareva Cloud», Республика Армения. Счёт, акт и инвойс на каждое пополнение, банковский перевод в рублях.
Написать сразу: ceo@kosareva.cloud, +7 995 154-15-35, @kosareva_cloud
Частые вопросы
Что такое RAG-система простыми словами? +
Это связка поиска и языковой модели: сначала по вопросу человека находятся нужные куски ваших документов, затем модель пишет ответ, опираясь только на них. Аббревиатура расшифровывается как retrieval augmented generation — «генерация, дополненная поиском». Смысл в том, что модель не выдумывает ответ из своей памяти, а пересказывает найденное, и на каждый ответ можно показать источник.
Сколько стоит RAG-система в рублях? +
Разово за индексацию — 21,6 ₽ за миллион токенов: база на 10 миллионов токенов обойдётся в 216 ₽. Дальше платите только за вопросы: тысяча ответов в месяц на GLM-5.3 Flash стоит около 41 ₽, на Gemini 3.8 Flash — около 446 ₽. Абонентской платы нет, векторная база бесплатная и ставится у вас.
Какая модель эмбеддингов нужна для русского языка? +
В нашем каталоге это Gemini Embedding 2: вектор на 3072 измерения, до 2048 токенов на фрагмент, 21,6 ₽ за миллион токенов. Она хорошо держит смысл русского текста и принимает список фрагментов за один запрос, поэтому индексация идёт пачками, а не по строчке.
Можно ли обойтись без RAG и просто отдать документы модели? +
Да, если документов немного. Gemini 3.8 Flash держит в контексте миллион токенов — около 2 500 страниц, и сотню страниц можно отдавать в каждый запрос целиком. Но платить придётся за весь объём при каждом вопросе: сотня страниц стоит около 5,7 ₽, то есть тысяча вопросов — 5 700 ₽ против 450 ₽ у RAG. Порог окупаемости проходит по числу вопросов, а не по размеру базы.
Нужна ли отдельная векторная база данных? +
Нужна, но покупать её не нужно. Qdrant, Chroma или расширение pgvector для PostgreSQL — открытые и бесплатные, ставятся на ваш сервер и никуда не отдают данные. Мы продаём только модели: эмбеддинги и генерацию ответа.
Данные компании уходят за границу? +
Векторная база и сами документы остаются у вас. За границу уходит только текст фрагмента в момент расчёта вектора и текст найденных фрагментов в момент ответа. Если и этого нельзя — ставится шлюз API Guard: он заменяет в запросе почты, телефоны, ИНН, СНИЛС и паспорта на заглушки, а в ответе возвращает настоящие значения.
Чем это отличается от дообучения модели на своих данных? +
Дообучение меняет саму модель и стоит дорого, а обновить в ней один документ нельзя — только переучивать заново. RAG ничего в модели не меняет: поменялся регламент — переиндексировали одну страницу за копейки, и система отвечает по-новому со следующего вопроса. Для корпоративных знаний, которые постоянно меняются, RAG почти всегда правильнее.
Страница обновлена 6 сентября 2026 года.